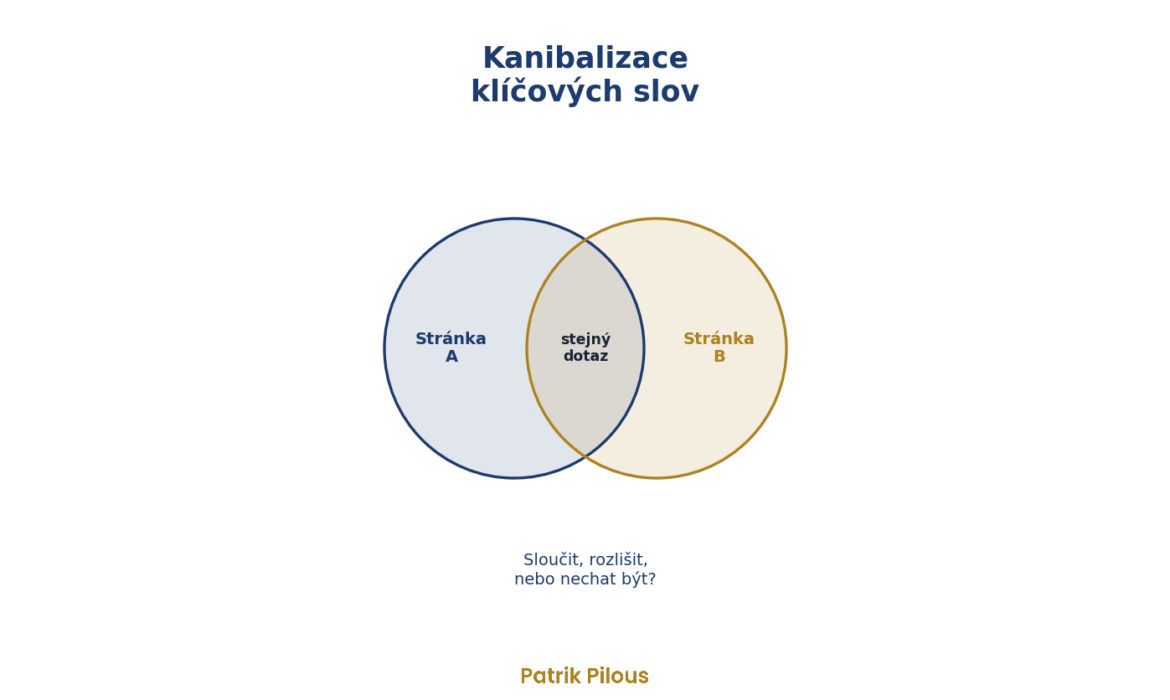
Kanibalizace klíčových slov nastává, když dvě a víc stránek téhož webu míří na stejný dotaz se stejným záměrem a Google mezi nimi přepíná. Žádná pak nemá pozici, jakou by měla sama. Důležitá je ta část o stejném záměru. Víc stránek na jeden dotaz ještě kanibalizace není.
Častá rada zní sloučit všechno, co se potká na stejném dotazu. Tak si ale web snadno rozbijete, protože spolu se slabší stránkou zmizí i odpověď na otázku, kterou lidé opravdu kladou.
Dvě stránky na jednom dotazu ještě nejsou kanibalizace
Reálná data z e-shopu s bazénovou chemií, se kterým pracuji (Search Console, 14. 6. až 11. 9. 2026). Na dotaz „chlor šok“ se zobrazují hlavně dvě stránky. Kategorie s přípravky a článek o tom, jak chlor šok dávkovat.
| Stránka | Imprese | Kliky | Pozice |
|---|---|---|---|
| Kategorie Chlor šok | 15 864 | 84 | 4,1 |
| Článek o dávkování chlor šoku | 9 460 | 26 | 9,9 |
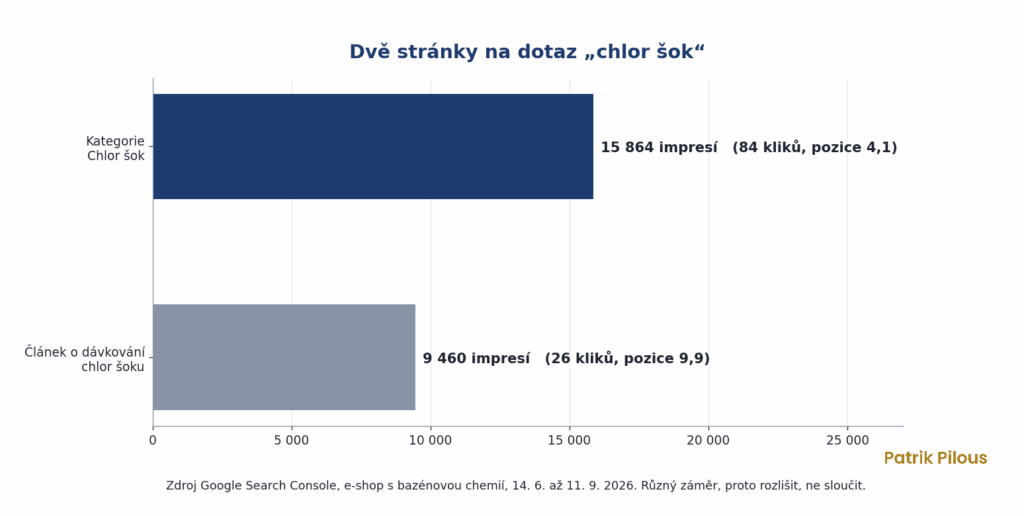
Je to kanibalizace? Podle dat to tak vypadá, článek bere 37 % impresí, které tyhle dvě stránky na dotaz dostaly. Podle záměru ne. Kdo chce chlor šok koupit, patří na kategorii. Kdo neví, kolik ho dát do bazénu, patří na článek. (Nízká míra prokliku kategorie na čtvrté pozici může mít víc příčin. U nákupních dotazů ale často stojí nad výsledky blok s produkty, který část kliků vezme.)
Sloučením by e-shop přišel o jednu z odpovědí. Správný krok je rozlišit. Článek už dávkování v titulku má, jen až na konci. Stačí ho posunout na začátek a hlavní dotaz „chlor šok“ nechat kategorii, aby se Google nemusel rozhodovat.
Stejně tak dotaz na jméno e-shopu. Zobrazí se na něj homepage, kontakty i hlavní kategorie, a to je úplně normální. Víc URL tu jen znamená, že Google ukazuje web jako celek, proto brandové dotazy při hledání kanibalizace vyřazuji. Stejně to vidí i Semrush ve svém průvodci, víc stránek na jednom dotazu podle něj kanibalizaci automaticky neznamená.
Trestá Google kanibalizaci?
Ne, aspoň ne tak, jak se to často říká. Za podobné stránky Google web netrestá, jen si mezi nimi vybírá. A nevybere vždycky tu, kterou byste chtěli vy.
Google to říká dlouho. Už v roce 2008 napsala Susan Moskwa na blogu Googlu pro webmastery, že trest za duplicitní obsah neexistuje, aspoň ne tak, jak si ho většina lidí představuje. Google z podobných stránek jednu vybere a ukáže ji.
„Nic jako penalizace za duplicitní obsah neexistuje.“
Susan Moskwa, Demystifying the „duplicate content penalty“, Google Search Central Blog, 2008
John Mueller z Googlu v září 2025 dodal, že stránky nejsou duplicitní jen proto, že se objeví ve stejných výsledcích hledání (Search Engine Journal). A podle dokumentace Googlu je canonical jen nápověda, ne pravidlo, takže si Google může vybrat jinou stránku, než kterou označíte.
Proč to tedy řešit? Protože cena není v trestu, ale v rozdělení. Kliky i odkazy se dělí mezi dvě stránky, takže ani jedna nesbírá všechno, co by mohla mít sama. Když Google navíc stránky střídá, kolísá pozice i míra prokliku a z dat se špatně čte, co vlastně funguje.
Jak kanibalizaci najít
Nejrychlejší je Search Console. Postup pro jeden dotaz zabere pár minut a žádný placený nástroj k němu nepotřebujete.
- V přehledu Výkon klikněte na Přidat filtr, zvolte Dotaz a zadejte přesný dotaz, který chcete prověřit.
- Přepněte na záložku Stránky (imprese tam najdete pod názvem Zobrazení).
- Nastavte období posledních tří měsíců, kratší okno ukáže víc náhody než trendu.
- Když se objeví víc URL a slabší z nich má aspoň 5 % impresí, máte kandidáta. Zapište si podíl impresí každé stránky.
Pro stovky dotazů najednou se hodí nástroje, které tohle projedou samy. Já používám Marketing Miner, který kromě dat ze Search Console sleduje i samotné výsledky vyhledávání. Stejná data jdou vytáhnout i přes API Search Console do tabulky, když chcete mít dimenze dotaz a stránka vedle sebe.
Abych nehonil šum, držím se pracovních prahů. Data za posledních 90 dní, dotaz aspoň s 30 impresemi a slabší stránka musí mít aspoň 5 % impresí dotazu. Brandové dotazy vyřazuji, jinak zaplaví celý přehled. Ve filtru dotazu stačí zvolit vlastní regulární výraz, nastavit, že mu dotaz neodpovídá, a vepsat varianty názvu značky s diakritikou i bez ní, oddělené svislou čarou.
Přepínání je silnější důkaz než sdílení
Sdílení impresí ukazuje kandidáta, přepínání v čase ho potvrdí. Marketing Miner u každého dotazu ukazuje, kolikrát se v poslední době vystřídala stránka, kterou Google ukazuje. U e-shopu s dámskou módou našel v srpnu 2026 celkem 304 dotazů s dohromady 38 520 hledáními měsíčně, na které rankovalo víc stránek. U „baggy kalhot“ se stránky v jeho sledování vystřídaly 108krát při 830 hledáních měsíčně. Google si tam vůbec neumí vybrat (číslo z nástroje beru s nadhledem, záleží, jak často měří, ale směr je jasný).
| Počet přehození | Jak to číst |
|---|---|
| 0 až 3 | stabilní, Google si vybral |
| 4 až 15 | kolísá, stojí za pohled |
| 16 až 50 | vážné, Google přehazuje |
| nad 50 | rozhodnout hned, tady se ztrácí pozice |
Prahy v tabulce jsou moje pracovní, ne pravidlo Googlu. Přehozením se myslí, že mezi dvěma měřeními ukázal Google na dotaz jinou stránku webu než předtím.
Bez nástroje jde přepínání poznat i v Search Console. Nechte filtr na dotazu, přidejte filtr na stránku A a podívejte se na graf zobrazení. Pak totéž pro stránku B. Graf ukazuje dny, které jsou moc rozházené, hledejte proto celé týdny. Když jedna křivka padá přesně v týdnech, kdy druhá roste, Google je nejspíš střídá. Pro jistotu se podívejte i na celý dotaz bez filtru stránky. Když celkové zobrazení zůstává podobné a mění se jen to, která stránka je dostává, jde o přepínání, ne o výkyv poptávky.
Rozhoduje záměr, ne slug
U každé dvojice stránek se ptám, jestli míří na stejný záměr. Pomůže typ stránky. Kategorie, produkt, článek a filtr mají každá jinou roli a jen některé kombinace jsou opravdu problém.
| Kombinace stránek | Záměr | Výchozí verdikt |
|---|---|---|
| Kategorie a kategorie | stejný | kanibalizace |
| Kategorie a filtr téže kategorie | stejný, když filtr cílí na hlavní dotaz | rozlišit |
| Kategorie a článek | většinou různý | v pořádku, když titulky záměr rozlišují |
| Produkt a jeho varianta | stejný | kanibalizace |
| Dva články na stejné téma | stejný | kanibalizace |
| Produkt a kategorie | různý | v pořádku, hlídat prolinkování |
Když si nejsem jistý, otevřu obě stránky a porovnám titulek a H1. Ze slugu se hádat nevyplácí, URL často vznikla dávno a o obsahu už nic neříká. Víc o tom, jak záměr poznat, píšu v článku Vyhledávací záměr.
Co s tím dělat
Možnosti jsou čtyři a jen jedna z nich je slučování. Výběr se řídí tím, jak se stránky dělí o imprese a jestli míří na stejný záměr.
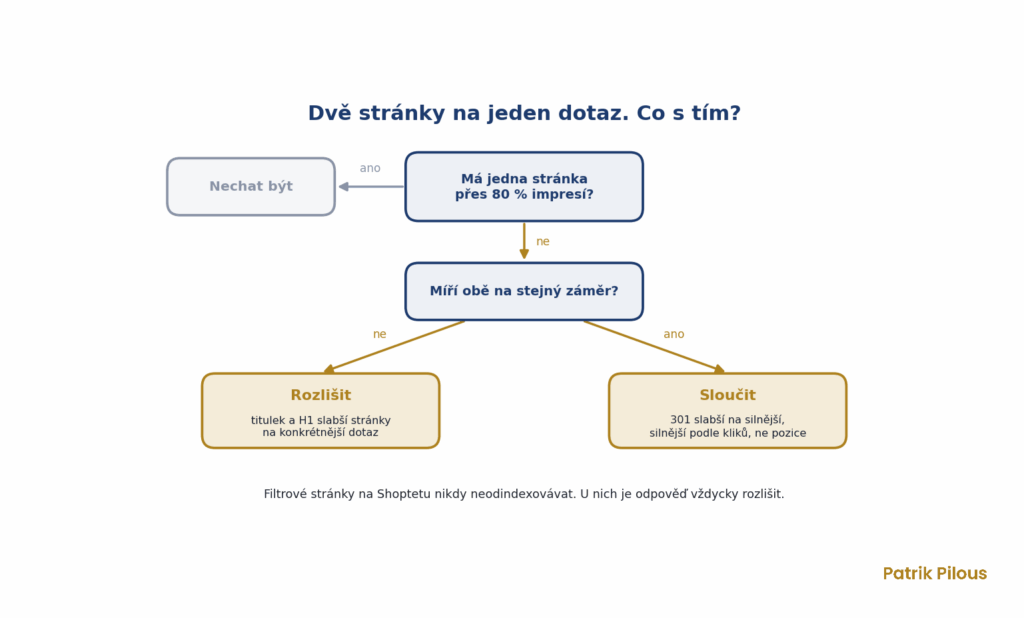
- Nechat být. Jedna stránka má víc než 80 % impresí a nestřídá se. Google si vybral, není co řešit.
- Sloučit. Stejný záměr, dělí se zhruba napůl a obě jsou až za první desítkou výsledků, případně se často přehazují. Slabší stránku přesměrovat 301 na silnější a přenést do ní, co v ní bylo dobré.
- Rozlišit. Stránky mají různý záměr, nebo jedna míří na užší dotaz, ale kvůli titulkům si je Google plete. Přepsat titulek a H1 slabší stránky na konkrétnější dotaz.
- Kanonizovat. Jen u technických duplicit, třeba stejný obsah na URL s parametry. Jako náplast na dvě skutečné stránky canonical nefunguje.
Mezi tím je šedá zóna. Když se stránky se stejným záměrem dělí třeba 60 ku 40 nebo jsou obě v první desítce, zkuste nejdřív rozlišit a sloučení si nechte na dobu, kdy rozlišení nezabere.
Která stránka zůstane? Ta, která lépe odpovídá záměru dotazu. Když odpovídají obě, rozhoduje, co stránka vydělává, tedy konverze z Google Analytics. A když ani to nerozhodne, vyhrává stránka s víc kliky ze Search Console, ne ta s lepší pozicí.
Proč ne noindex nebo canonical
Nejrychlejší „řešení“, které se nabízí, je dát slabší stránce noindex. Google ji pak přestane ukazovat, jenže odkazy, které na ni vedou, nikam nepředá a lidé z jejích dotazů nedojdou nikam. Přesměrování 301 obojí přenese na stránku, která zůstává.
Canonical mezi dvěma rozdílnými stránkami je zase jen nápověda. Když obsah není skoro stejný, Google ji může přehlédnout a vybrat si sám. Přesměrování Google ve své dokumentaci řadí mezi silné signály a na rozdíl od canonicalu přenese i návštěvníky. Proto canonical patří k technickým duplicitám a u dvou skutečných stránek se rozhoduje mezi sloučením a rozlišením.
Jak sloučit dvě stránky, aby se nic neztratilo
Sloučení je jediný z kroků, který se špatně vrací. Proto ho dělám podle stejného seznamu pokaždé.
- Vyexportujte ze Search Console všechny dotazy slabší stránky, které mají kliky. To je seznam toho, co nesmí zmizet.
- Přeneste do silnější stránky odstavce, které na tyhle dotazy odpovídají. Zbytek nechte být, slučování není sčítání textů.
- Nastavte přesměrování 301 ze slabší stránky na silnější.
- Přepište interní odkazy, ať vedou rovnou na cílovou stránku, ne přes přesměrování.
- Odeberte slabší URL ze sitemapy a přesměrování nechte natrvalo.
- Po čtyřech až osmi týdnech zkontrolujte dotazy z prvního bodu. Když některý spadl, chybí v cílové stránce odpověď.
Nejdražší chyba je přeskočit první bod. Slabší stránka na první pohled „nic nedělá“, jenže často drží pár dlouhých dotazů, které přivádí přesně ty zákazníky, kteří nakupují. Po smazání bez přenosu obsahu zmizí i oni.
Specifika e-shopů na Shoptetu
Na Shoptetu se kanibalizace nejčastěji rodí ze tří věcí. Duplicitní kategorie, které vznikly během let (u bazénové chemie jsem našel dvě URL pro pískové filtrace a tři pro zákal a vločkovače). Filtrové stránky, které cílí na stejný dotaz jako jejich kategorie. A články, které titulkem míří na hlavní dotaz vlastní kategorie.
U filtrů platí jedno pravidlo, které neporušuji. Parametrické stránky s vlastním titulkem a popisem se nikdy neodindexovávají, protože přivádí long tail. Řešení je vždycky rozlišení, tedy titulek a H1 filtru na konkrétní vlastnost („solární sprchy bez přívodu vody“), ne na hlavní dotaz kategorie.
Technická duplicita je něco jiného. To je URL s parametry bez vlastního obsahu, třeba řazení podle ceny, a tam canonical patří. Jak s filtry pracuji, popisuji na stránce SEO pro e-shopy.
Kanibalizace na blogu a ve WordPressu
Na obsahových webech vzniká kanibalizace jinak. Ne z kategorií, ale z času. Článek „Jak na SEO“ z roku 2021, pak „SEO tipy pro začátečníky“ o dva roky později a nakonec „Kompletní průvodce SEO“. Tři texty na jeden záměr, každý napsaný někým, kdo o tom předchozím nevěděl.
Řešení je skoro vždycky jedno. Nejsilnější článek aktualizovat, do něj přenést to dobré ze slabších a ty přesměrovat. Nový článek na stejný dotaz, protože ten starý zestárl, je nejdražší způsob, jak si kanibalizaci vyrobit.
Druhý zdroj jsou archivy. WordPress umí z každého štítku, kategorie, autora i data udělat samostatnou stránku. Štítek s jedním dvěma články pak soupeří s článkem samotným, a přitom čtenáři nic nedává. Takové štítky zrušte a přesměrujte na hlavní článek. Když je zrušit nejde, vyřaďte je z indexu, třeba v nastavení Yoastu. Štítek obvykle nemá odkazy zvenku, takže se tím nic neztratí.
Jak kanibalizaci předcházet
Levnější než kanibalizaci opravovat je nevyrobit ji. Stačí k tomu tři návyky, které nic nestojí, jen disciplínu.
- Jeden záměr, jedna URL. Mějte jednoduchou tabulku, kde u každého důležitého dotazu a jeho záměru stojí stránka, která na něj má rankovat. Kdo píše nový text nebo zakládá kategorii, nejdřív se podívá do ní.
- Před psaním do Search Console. U každého nového článku nejdřív ověřuji, jestli na hlavní dotaz už nerankuje jiná stránka webu. Když ano, většinou je lepší ji rozšířit než psát vedle ní.
- Interní odkazy jedním směrem. Když odkazujete s textem „chlor šok“, vždycky na kategorii, s textem „dávkování chlor šoku“ vždycky na článek. Interní odkazy Googlu napovídají, kterou stránku na dotaz myslíte, a rozdělené odkazy mu napovídají obě.
Kontrolu kanibalizace pak stačí dělat jednou za kvartál a po každé větší změně struktury webu, třeba po migraci nebo přejmenování kategorií. Po migraci se kanibalizace objeví snadno, protože staré a nové URL nějakou dobu žijí vedle sebe.
Jak poznat, že oprava zabrala
První týden se nedívejte. Google potřebuje čas, než stránky znovu projde a srovná si je. Výsledek hodnotím po čtyřech až osmi týdnech na stejném dotazu v Search Console.
Oprava zabrala, když po sloučení drží jedna stránka přes 80 % impresí, nebo po rozlišení dostává každá svůj dotaz. Přepínání ustane a pozice se zlepší. Je to stejný stav, ve kterém na začátku není co řešit, jen se k němu web dostal vaším zásahem. U sezónního zboží srovnávejte se stejným obdobím loni, jinak vám jaro udělá z každé opravy úspěch.
Na první kontrolu stačí půl hodiny. Otevřete v Search Console deset nebrandových dotazů s nejvíc impresemi, u každého se podívejte na záložku Stránky a zapište si ty, kde se dvě URL dělí o víc než 5 % impresí. U nich rozhodněte podle tabulky výš. Pokud chcete kanibalizaci projet na celém webu, je to součást SEO auditu, nebo mi rovnou napište.