
Kanibalizácia kľúčových slov nastáva, keď dve a viac stránok toho istého webu cieli na rovnaký dopyt s rovnakým zámerom a Google medzi nimi prepína. Žiadna potom nemá pozíciu, akú by mala sama. Dôležitá je tá časť o rovnakom zámere. Viac stránok na jeden dopyt ešte nie je kanibalizácia.
Častá rada znie zlúčiť všetko, čo sa stretne na rovnakom dopyte. Tak si však web ľahko rozbijete, pretože spolu so slabšou stránkou zmizne aj odpoveď na otázku, ktorú ľudia naozaj kladú.
Dve stránky na jednom dopyte ešte nie sú kanibalizácia
Reálne dáta z e-shopu s bazénovou chémiou, s ktorým pracujem (Search Console, 14. júna až 11. septembra 2026). Na dopyt „chlór šok“ sa zobrazujú hlavne dve stránky. Kategória s prípravkami a článok o tom, ako chlór šok dávkovať.
| Stránka | Impresie | Kliknutia | Pozícia |
|---|---|---|---|
| Kategória Chlór šok | 15 864 | 84 | 4,1 |
| Článok o dávkovaní chlór šoku | 9 460 | 26 | 9,9 |
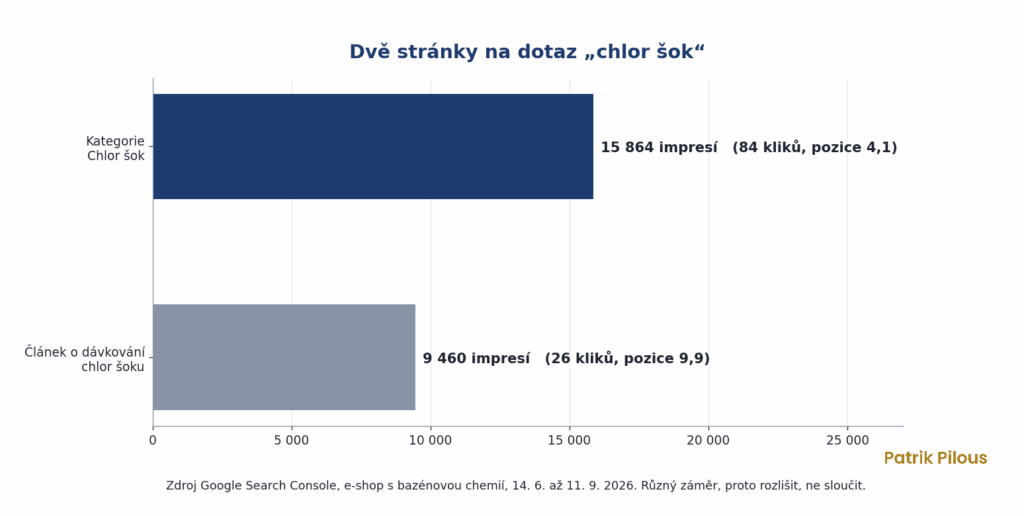
Je to kanibalizácia? Podľa dát to tak vyzerá, článok berie 37 % impresií, ktoré tieto dve stránky na dopyt dostali. Podľa zámeru nie. Kto chce chlór šok kúpiť, patrí na kategóriu. Kto nevie, koľko ho dať do bazéna, patrí na článok. (Nízka miera prekliku kategórie na štvrtej pozícii môže mať viac príčin. Pri nákupných dopytoch však často stojí nad výsledkami blok s produktmi, ktorý časť kliknutí zoberie.)
Zlúčením by e-shop prišiel o jednu z odpovedí. Správny krok je rozlíšiť. Článok už dávkovanie v titulku má, len až na konci. Stačí ho posunúť na začiatok a hlavný dopyt „chlór šok“ nechať kategórii, aby sa Google nemusel rozhodovať.
Rovnako aj dopyt na meno e-shopu. Zobrazí sa na neho homepage, kontakty aj hlavné kategórie, a to je úplne normálne. Viac URL tu len znamená, že Google ukazuje web ako celok, preto brandové dopyty pri hľadaní kanibalizácie vyraďujem. Rovnako to vidí aj Semrush vo svojom sprievodcovi, viac stránok na jednom dopyte podľa neho kanibalizáciu automaticky neznamená.
Trestá Google kanibalizáciu?
Nie, aspoň nie tak, ako sa to často hovorí. Za podobné stránky Google web netrestá, len si medzi nimi vyberá. A nevyberie vždy tú, ktorú by ste chceli vy.
Google to hovorí už dlho. Už v roku 2008 napísala Susan Moskwa na blogu Googlu pre webmasterov, že trest za duplicitný obsah neexistuje, aspoň nie tak, ako si ho väčšina ľudí predstavuje. Google z podobných stránok jednu vyberie a ukáže ju.
„Nič ako penalizácia za duplicitný obsah neexistuje.“
Susan Moskwa, Demystifying the „duplicate content penalty“, Google Search Central Blog, 2008
John Mueller z Googlu v septembri 2025 dodal, že stránky nie sú duplicitné len preto, že sa objavia v rovnakých výsledkoch vyhľadávania (Search Engine Journal). A podľa dokumentácie Googlu je canonical len nápoveda, nie pravidlo, takže si Google môže vybrať inú stránku, než ktorú označíte.
Prečo to teda riešiť? Pretože cena nie je v treste, ale v rozdelení. Kliknutia aj odkazy sa delia medzi dve stránky, takže ani jedna nezbiera všetko, čo by mohla mať sama. Keď Google navyše stránky strieda, kolíše pozícia aj miera prekliku a z dát sa ťažko číta, čo vlastne funguje.
Ako kanibalizáciu nájsť
Najrýchlejšia je Search Console. Postup pre jeden dopyt zaberie pár minút a žiadny platený nástroj k nemu nepotrebujete.
- V prehľade Výkonnosť kliknite na Pridať filter, zvoľte Dopyt a zadajte presný dopyt, ktorý chcete preveriť.
- Prepnite na záložku Stránky (impresie tam nájdete pod názvom Zobrazenia).
- Nastavte obdobie posledných troch mesiacov, kratšie okno ukáže viac náhody než trendu.
- Keď sa objaví viac URL a slabšia z nich má aspoň 5 % impresií, máte kandidáta. Zapíšte si podiel impresií každej stránky.
Pre stovky dopytov naraz sa hodia nástroje, ktoré toto prejdú samy. Ja používam Marketing Miner, ktorý okrem dát zo Search Console sleduje aj samotné výsledky vyhľadávania. Rovnaké dáta sa dajú vytiahnuť aj cez API Search Console do tabuľky, keď chcete mať dimenzie dopyt a stránka vedľa seba.
Aby som nenaháňal šum, držím sa pracovných prahov. Dáta za posledných 90 dní, dopyt aspoň s 30 impresiami a slabšia stránka musí mať aspoň 5 % impresií dopytu. Brandové dopyty vyraďujem, inak zaplavia celý prehľad. Vo filtri dopytu stačí zvoliť vlastný regulárny výraz, nastaviť, že mu dopyt nezodpovedá, a vpísať varianty názvu značky s diakritikou aj bez nej, oddelené zvislou čiarou.
Prepínanie je silnejší dôkaz než zdieľanie
Zdieľanie impresií ukazuje kandidáta, prepínanie v čase ho potvrdí. Marketing Miner pri každom dopyte ukazuje, koľkokrát sa v poslednom čase vystriedala stránka, ktorú Google ukazuje. Pri e-shope s dámskou módou našiel v auguste 2026 celkom 304 dopytov s dohromady 38 520 vyhľadávaniami mesačne, na ktoré rankovalo viac stránok. Pri „baggy nohaviciach“ sa stránky v jeho sledovaní vystriedali 108-krát pri 830 vyhľadávaniach mesačne. Google si tam vôbec nevie vybrať (číslo z nástroja beriem s nadhľadom, záleží, ako často meria, ale smer je jasný).
| Počet prehodení | Ako to čítať |
|---|---|
| 0 až 3 | stabilné, Google si vybral |
| 4 až 15 | kolíše, stojí za pohľad |
| 16 až 50 | vážne, Google prehadzuje |
| nad 50 | rozhodnúť hneď, tu sa stráca pozícia |
Prahy v tabuľke sú moje pracovné, nie pravidlo Googlu. Prehodením sa myslí, že medzi dvoma meraniami ukázal Google na dopyt inú stránku webu než predtým.
Bez nástroja sa dá prepínanie spoznať aj v Search Console. Nechajte filter na dopyte, pridajte filter na stránku A a pozrite sa na graf zobrazení. Potom to isté pre stránku B. Graf ukazuje dni, ktoré sú príliš rozhádzané, hľadajte preto celé týždne. Keď jedna krivka padá presne v týždňoch, keď druhá rastie, Google ich najskôr strieda. Pre istotu sa pozrite aj na celý dopyt bez filtra stránky. Keď celkové zobrazenia zostávajú podobné a mení sa len to, ktorá stránka ich dostáva, ide o prepínanie, nie o výkyv dopytu.
Rozhoduje zámer, nie slug
Pri každej dvojici stránok sa pýtam, či cielia na rovnaký zámer. Pomôže typ stránky. Kategória, produkt, článok a filter majú každý inú úlohu a len niektoré kombinácie sú naozaj problém.
| Kombinácia stránok | Zámer | Predvolený verdikt |
|---|---|---|
| Kategória a kategória | rovnaký | kanibalizácia |
| Kategória a filter tej istej kategórie | rovnaký, keď filter cieli na hlavný dopyt | rozlíšiť |
| Kategória a článok | väčšinou rozdielny | v poriadku, keď titulky zámer rozlišujú |
| Produkt a jeho variant | rovnaký | kanibalizácia |
| Dva články na rovnakú tému | rovnaký | kanibalizácia |
| Produkt a kategória | rozdielny | v poriadku, strážiť prelinkovanie |
Keď si nie som istý, otvorím obe stránky a porovnám titulok a H1. Zo slugu sa hádať neoplatí, URL často vznikla dávno a o obsahu už nič nehovorí. Viac o tom, ako zámer spoznať, píšem v článku Vyhľadávací zámer.
Čo s tým robiť
Možnosti sú štyri a len jedna z nich je zlučovanie. Výber sa riadi tým, ako sa stránky delia o impresie a či cielia na rovnaký zámer.
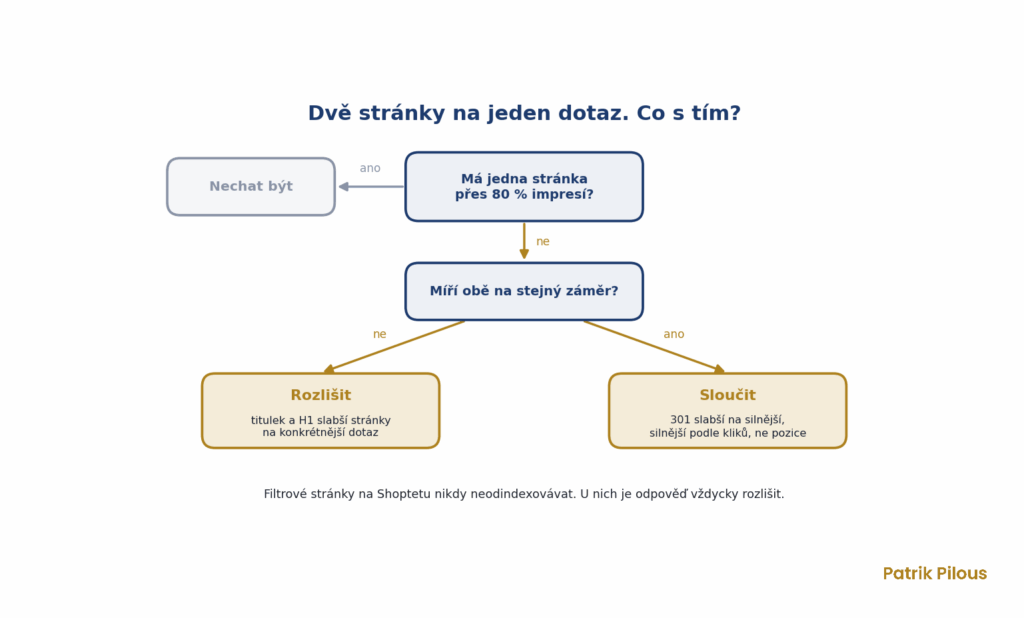
- Nechať tak. Jedna stránka má viac než 80 % impresií a nestrieda sa. Google si vybral, nie je čo riešiť.
- Zlúčiť. Rovnaký zámer, delia sa zhruba napoly a obe sú až za prvou desiatkou výsledkov, prípadne sa často prehadzujú. Slabšiu stránku presmerovať 301 na silnejšiu a preniesť do nej, čo v nej bolo dobré.
- Rozlíšiť. Stránky majú rozdielny zámer alebo jedna cieli na užší dopyt, ale kvôli titulkom si ich Google pletie. Prepísať titulok a H1 slabšej stránky na konkrétnejší dopyt.
- Kanonizovať. Len pri technických duplicitách, napríklad rovnaký obsah na URL s parametrami. Ako náplasť na dve skutočné stránky canonical nefunguje.
Medzi tým je šedá zóna. Keď sa stránky s rovnakým zámerom delia napríklad 60 ku 40 alebo sú obe v prvej desiatke, skúste najskôr rozlíšiť a zlúčenie si nechajte na čas, keď rozlíšenie nezaberie.
Ktorá stránka zostane? Tá, ktorá lepšie zodpovedá zámeru dopytu. Keď zodpovedajú obe, rozhoduje, čo stránka zarába, teda konverzie z Google Analytics. A keď ani to nerozhodne, vyhráva stránka s viac kliknutiami zo Search Console, nie tá s lepšou pozíciou.
Prečo nie noindex alebo canonical
Najrýchlejšie „riešenie“, ktoré sa ponúka, je dať slabšej stránke noindex. Google ju potom prestane ukazovať, lenže odkazy, ktoré na ňu vedú, nikam neodovzdá a ľudia z jej dopytov sa nikam nedostanú. Presmerovanie 301 oboje prenesie na stránku, ktorá zostáva.
Canonical medzi dvoma rozdielnymi stránkami je zasa len nápoveda. Keď obsah nie je takmer rovnaký, Google ju môže prehliadnuť a vybrať si sám. Presmerovanie Google vo svojej dokumentácii radí medzi silné signály a na rozdiel od canonicalu prenesie aj návštevníkov. Preto canonical patrí k technickým duplicitám a pri dvoch skutočných stránkach sa rozhoduje medzi zlúčením a rozlíšením.
Ako zlúčiť dve stránky, aby sa nič nestratilo
Zlúčenie je jediný z krokov, ktorý sa ťažko vracia. Preto ho robím zakaždým podľa rovnakého zoznamu.
- Vyexportujte zo Search Console všetky dopyty slabšej stránky, ktoré majú kliknutia. To je zoznam toho, čo nesmie zmiznúť.
- Preneste do silnejšej stránky odseky, ktoré na tieto dopyty odpovedajú. Zvyšok nechajte tak, zlučovanie nie je sčítanie textov.
- Nastavte presmerovanie 301 zo slabšej stránky na silnejšiu.
- Prepíšte interné odkazy, nech vedú rovno na cieľovú stránku, nie cez presmerovanie.
- Odoberte slabšiu URL zo sitemapy a presmerovanie nechajte natrvalo.
- Po štyroch až ôsmich týždňoch skontrolujte dopyty z prvého bodu. Keď niektorý klesol, chýba v cieľovej stránke odpoveď.
Najdrahšia chyba je preskočiť prvý bod. Slabšia stránka na prvý pohľad „nič nerobí“, lenže často drží pár dlhých dopytov, ktoré privádzajú presne tých zákazníkov, ktorí nakupujú. Po zmazaní bez prenosu obsahu zmiznú aj oni.
Špecifiká e-shopov na Shoptete
Na Shoptete sa kanibalizácia najčastejšie rodí z troch vecí. Duplicitné kategórie, ktoré vznikli počas rokov (pri bazénovej chémii som našiel dve URL pre pieskové filtrácie a tri pre zákal a vločkovače). Filtrové stránky, ktoré cielia na rovnaký dopyt ako ich kategória. A články, ktoré titulkom mieria na hlavný dopyt vlastnej kategórie.
Pri filtroch platí jedno pravidlo, ktoré neporušujem. Parametrické stránky s vlastným titulkom a popisom sa nikdy nevyraďujú z indexu, pretože privádzajú long tail. Riešením je vždy rozlíšenie, teda titulok a H1 filtra na konkrétnu vlastnosť („solárne sprchy bez prívodu vody“), nie na hlavný dopyt kategórie.
Technická duplicita je niečo iné. To je URL s parametrami bez vlastného obsahu, napríklad radenie podľa ceny, a tam canonical patrí. Ako s filtrami pracujem, opisujem na stránke SEO pre e-shopy.
Kanibalizácia na blogu a vo WordPresse
Na obsahových weboch vzniká kanibalizácia inak. Nie z kategórií, ale z času. Článok „Ako na SEO“ z roku 2021, potom „SEO tipy pre začiatočníkov“ o dva roky neskôr a nakoniec „Kompletný sprievodca SEO“. Tri texty na jeden zámer, každý napísaný niekým, kto o tom predchádzajúcom nevedel.
Riešenie je takmer vždy jedno. Najsilnejší článok aktualizovať, preniesť doň to dobré zo slabších a tie presmerovať. Nový článok na rovnaký dopyt, pretože ten starý zastaral, je najdrahší spôsob, ako si kanibalizáciu vyrobiť.
Druhým zdrojom sú archívy. WordPress vie z každého štítku, kategórie, autora aj dátumu urobiť samostatnú stránku. Štítok s jedným či dvoma článkami potom súperí so samotným článkom, a pritom čitateľovi nič nedáva. Takéto štítky zrušte a presmerujte na hlavný článok. Ak ich zrušiť nejde, vyraďte ich z indexu, napríklad v nastaveniach Yoastu. Štítok zvyčajne nemá odkazy zvonka, takže sa tým nič nestratí.
Ako kanibalizácii predchádzať
Lacnejšie než kanibalizáciu opravovať je nevyrobiť ju. Stačia na to tri návyky, ktoré nič nestoja, len disciplínu.
- Jeden zámer, jedna URL. Majte jednoduchú tabuľku, kde pri každom dôležitom dopyte a jeho zámere stojí stránka, ktorá naň má rankovať. Kto píše nový text alebo zakladá kategóriu, najprv sa pozrie do nej.
- Pred písaním do Search Console. Pri každom novom článku najprv overujem, či na hlavný dopyt už nerankuje iná stránka webu. Ak áno, väčšinou je lepšie ju rozšíriť, než písať vedľa nej.
- Interné odkazy jedným smerom. Keď odkazujete s textom „chlór šok“, vždy na kategóriu, s textom „dávkovanie chlór šoku“ vždy na článok. Interné odkazy Googlu napovedajú, ktorú stránku na dopyt myslíte, a rozdelené odkazy mu napovedajú obe.
Kontrolu kanibalizácie potom stačí robiť raz za štvrťrok a po každej väčšej zmene štruktúry webu, napríklad po migrácii alebo premenovaní kategórií. Po migrácii sa kanibalizácia objaví ľahko, pretože staré a nové URL nejaký čas žijú vedľa seba.
Ako spoznať, že oprava zabrala
Prvý týždeň sa nepozerajte. Google potrebuje čas, kým stránky znova prejde a usporiada si ich. Výsledok hodnotím po štyroch až ôsmich týždňoch na rovnakom dopyte v Search Console.
Oprava zabrala, keď po zlúčení drží jedna stránka viac ako 80 % impresií, alebo po rozlíšení dostáva každá svoj dopyt. Prepínanie ustane a pozície sa zlepšia. Je to rovnaký stav, v ktorom na začiatku nie je čo riešiť, len sa k nemu web dostal vaším zásahom. Pri sezónnom tovare porovnávajte s rovnakým obdobím vlani, inak vám jar urobí z každej opravy úspech.
Na prvú kontrolu stačí pol hodiny. Otvorte v Search Console desať nebrandových dopytov s najviac impresiami, pri každom sa pozrite na záložku Stránky a zapíšte si tie, kde sa dve URL delia o viac ako 5 % impresií. Pri nich rozhodnite podľa tabuľky vyššie. Ak chcete kanibalizáciu prejsť na celom webe, je to súčasť SEO auditu, alebo mi rovno napíšte.

