Značka má v hlavě zákazníka dvě vrstvy. Entitu, tedy jasnou představu o tom, kdo značka je, a kolem ní síť asociací, se kterými si ji lidé spojují. Vyhledávače i jazykové modely jako ChatGPT nebo Gemini si obraz značky skládají podobně, z toho, co o ní píše web. Kdo chce být vidět v Googlu i v odpovědích AI, potřebuje silnou entitu a kolem ní asociace, které internet opakuje.
Samotným asociacím z pohledu psychologie se věnuji v článku Asociace se značkou, jak vznikají a proč jsou důležité. Tady je beru optikou SEO a GEO, tedy vyhledávání a odpovědí AI.
Co je entita a co asociace
Entita je značka jako samostatný, jasně vymezený subjekt. Má jméno, obor, lidi, příběh a hlavně odpověď na otázku, kdo je, pro koho a čím se liší. Silnou entitu nespletete s konkurencí ani s kategorií. Když se řekne Apple, v marketingu si nikdo nepředstaví ovoce.
Asociace jsou vazby, které z entity vedou. Řeknete Alza a vybaví se elektronika, AlzaBoxy a zelený mimozemšťan. Čím víc silných vazeb značka má, tím snáz si na ni člověk vzpomene ve chvíli, kdy něco potřebuje. Při nákupu pak obvykle vážně zvažuje jen pár značek, které ho napadnou jako první.
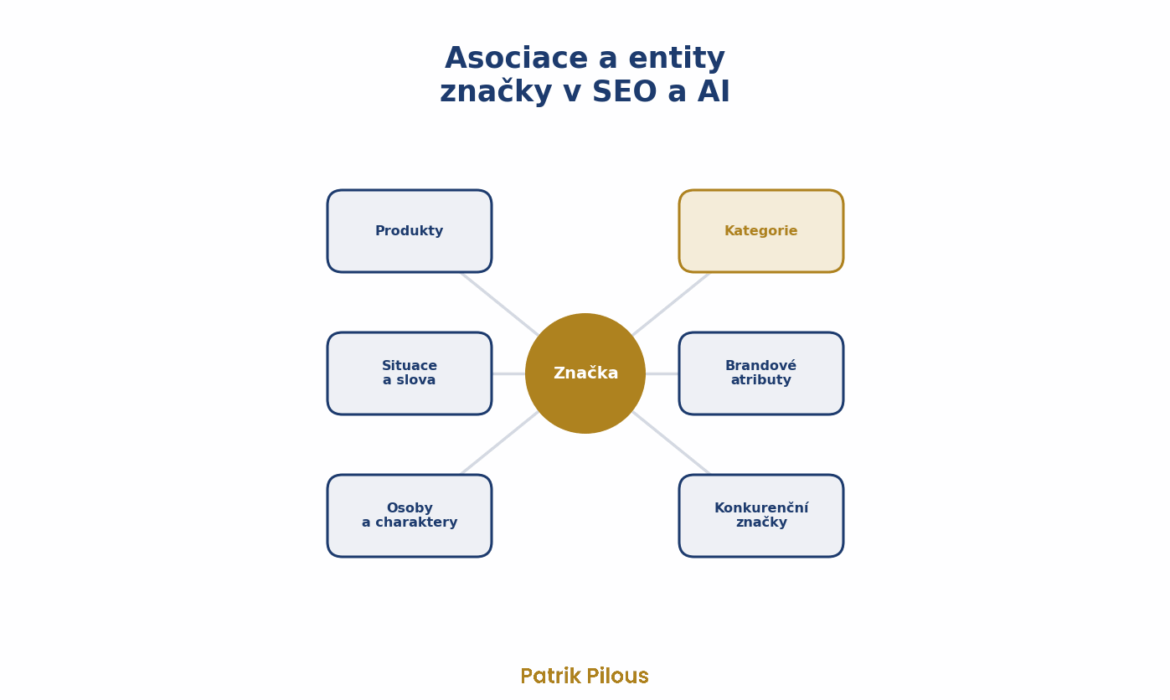
Entita je střed, asociace jsou čáry kolem. Bez jasného středu se asociace nemají čeho chytit. Když se e-shop jmenuje stejně jako kategorie, kterou prodává, zákazník si zapamatuje kategorii, ne jeho.
Marketing to popsal už v roce 1993. Kevin Lane Keller, tehdy ze Stanfordovy univerzity, přirovnal v časopise Journal of Marketing znalost značky k síti v paměti. Tvoří ji povědomí o značce a obraz značky, tedy soubor asociací.
„Hodnota značky vzniká, když má zákazník v paměti příznivé, silné a jedinečné asociace se značkou.“
anotace článku Conceptualizing, Measuring, and Managing Customer-Based Brand Equity od Kevina Lanea Kellera, Journal of Marketing, 1993
Keller mluvil o paměti lidí, ne o AI. Do toho, co sledovat v odpovědích jazykových modelů, ty tři vlastnosti volně převádím já.
| Vlastnost asociace | Co znamená | Jak ji poznáte v odpovědích AI |
|---|---|---|
| Síla | jak snadno si lidé značku s tématem spojí | jak často vás AI zmíní u otázek z kategorie |
| Příznivost | jestli je vazba pro zákazníka dobrá | v jakém tónu o vás AI mluví |
| Jedinečnost | jestli ji nemá i konkurence | jestli vás popíše něčím, co neříká o ostatních |
Z mé praxe nejčastěji chybí ta třetí. Značka, kterou AI popíše stejnými slovy jako tři konkurenty, má sice silné a příznivé asociace, ale nic, kvůli čemu by ji model doporučil jako první.
Z čeho se skládá silná entita
Silnou entitu nevytvoří logo ani jedna kampaň. Skládá se z několika věcí, které musí dávat smysl dohromady a opakovat se všude, kde o značce někdo mluví.
- Jméno, které si nikdo nesplete. Sdílíte ho s obcí, produktem nebo celou kategorií? Pak k němu musíte pořád dodávat, co děláte. Čím generičtější jméno, tím víc práce.
- Jedna věta. Kdo jste, pro koho a čím se lišíte. Z ní vychází brand positioning i unikátní prodejní argument.
- Rozpoznatelné prvky. Barva, maskot, slogan, tvar obalu. Fajfka Nike funguje i bez názvu.
- Lidé a příběh. Zakladatel nebo tvář značky dávají entitě charakter, který si lidé zapamatují snáz než firmu.
- Stejná fakta všude. Název, rok založení, sídlo, sortiment. Rok 2008 na webu a 2010 na LinkedInu mate zákazníky i stroje.
Vyhledávače tuhle logiku převzaly. Google v roce 2012 spustil Knowledge Graph s heslem „things, not strings“ a od té doby bere značky jako entity, ne jako řetězce znaků. V roce 2020 v něm podle Googlu bylo přes 500 miliard faktů o pěti miliardách entit.
Fakta Google bere ze stovek zdrojů a Wikipedie je podle něj jen jeden z nich. U firem to bývá hlavně web, katalogy, Wikidata, firemní profil na Googlu a strukturovaná data. Když zdroje říkají totéž, Google entitu pozná. Když si odporují, neví, čemu věřit.
Jak zjistit, jestli vás Google zná jako entitu
Než začnete entitu budovat, zjistěte, kde jste. Na orientační kontrolu jsou potřeba tři kroky, technický je jen ten prostřední.
1. Vyhledejte svůj název. Ukáže se k němu panel se značkou, logem a webem? Pak vás Google jako entitu skoro jistě zná. Když panel chybí, neznamená to automaticky opak. Když se ale místo vás ukáže jiná firma, obec nebo obecný pojem, máte problém se jménem, které si plete s jinými.
2. Nechte vývojáře zeptat se Knowledge Graphu. Google má veřejné rozhraní Knowledge Graph Search API, které k názvu vrátí odpovídající entity. Sám ale upozorňuje, že není stavěné pro ostrý provoz, takže je to orientační kontrola, ne měření.
3. Porovnejte fakta napříč zdroji. Projděte místa z tabulky a zapište si, kde se údaje liší. Každý rozpor v roce založení nebo v oboru je pro stroje důvod k pochybnostem.
| Kde | Co zkontrolovat |
|---|---|
| Vlastní web, stránka O nás a patička | název, rok založení, sídlo, IČO, čím se firma zabývá |
| Firemní profil na Googlu | název, kategorie, adresa, odkaz na web |
| Firmy.cz a oborové katalogy | stejné údaje a stejný popis oboru |
| LinkedIn a sociální sítě | název, popis, rok založení |
| Wikidata | jestli položka existuje a odkazuje na správný web |
| Obchodní rejstřík | oficiální název a sídlo, ke kterým se ostatní zdroje vztahují |
Wikidata ale nejsou firemní katalog, kam se značka zapíše sama. Podle pravidel Wikidat musí položka stát na vážných a veřejně dostupných zdrojích a placené úpravy se tam musí přiznat. Nejdřív proto zkontrolujte, jestli položka existuje a sedí, a opravujte hlavně zjevné chyby s odkazem na zdroj.
Jak entitu popsat strukturovanými daty
Když víte, kde jste, popište entitu Googlu i strojově. Na úvodní stránku patří strukturovaná data typu Organization. Podle dokumentace Googlu pomáhají vyhledávači pochopit údaje o firmě a odlišit ji ve výsledcích od jiných organizací. Vyplňte hlavně vlastnosti, které se dají ověřit i jinde.
| Vlastnost | Co do ní patří |
|---|---|
| name a alternateName | oficiální název a varianty, pod kterými vás lidé znají |
| legalName | název firmy z obchodního rejstříku |
| url a logo | adresa webu a logo |
| description | jedna věta o firmě, stejná jako v katalozích a na LinkedInu |
| foundingDate a address | rok založení a sídlo, stejně jako všude jinde |
| vatID | DIČ, pokud jste plátci DPH |
| sameAs | odkazy na profily, které patří vám, třeba LinkedIn, Wikidata nebo sociální sítě |
Slovník schema.org, který spolu založily Google, Microsoft, Yahoo a Yandex, popisuje sameAs jako odkaz na stránku, která jednoznačně určuje identitu dané věci, typicky Wikipedii, Wikidata nebo oficiální web. Je to vaše vlastní prohlášení, samo nic neověřuje. Propojí ale místa, kde si stroj fakta o vás ověřit může.
Do odpovědí AI vás strukturovaná data sama nedostanou. Pomáhají Googlu vás poznat a nesplést, co o vás AI řekne, se ale rozhoduje podle toho, co píše zbytek internetu.
Proč AI potřebuje entitu i asociace
Jazykový model nemá váš web uložený jako archiv. Z trénovacích dat si odnáší hlavně to, s jakými slovy, kategoriemi a konkurenty se vaše jméno objevuje, a co se v datech opakuje často, má větší šanci, že to v odpovědi zopakuje. Když navíc hledá na webu, jako Perplexity nebo ChatGPT s vyhledáváním, čte to, co o vás najde právě teď.
Kde o vás informace chybí nebo si odporují, model mezery zaplní tím, co zní pravděpodobně. Halucinace mají víc příčin. Jednotná a dohledatelná fakta o značce riziko snižují a na rozdíl od ostatních příčin je máte ve vlastních rukou.
Ahrefs porovnal 75 000 značek a počet zmínek značky na webu souvisel s viditelností v Režimu AI Googlu silněji (korelace 0,71) než síla domény měřená Domain Ratingem (0,29). Napříč nástroji vyšly nejsilněji zmínky na YouTube, kolem 0,74. Je to korelace, ne důkaz příčiny, a Ahrefs měření viditelnosti v AI prodává, takže s nadhledem.
Odkazy ale nepřestaly být důležité, jen působí jinde, než by člověk čekal. Common Crawl je otevřený archiv webu, ze kterého čerpá trénovací data řada velkých modelů. Podle Sebastiana Nagela z Common Crawlu měly v roce 2022 nejlépe propojené domény limit až 35 milionů adres a domény, na které skoro nic neodkazuje, jen tisíc.
Proč to řešit? Odpověď AI bere klikům místo. Pew Research Center sledoval v březnu 2025 prohlížení 900 dospělých Američanů. Když se nad výsledky Googlu objevilo shrnutí od AI, klikli na klasický odkaz v 8 % návštěv, bez shrnutí v 15 %. Na odkaz přímo ve shrnutí klikli jen v 1 % návštěv.
Kdo v odpovědi chybí, přichází o kontakt se zákazníkem, i když ve výsledcích pod ní stojí vysoko. Pro přehledy od AI a Režim AI v Googlu přitom podle dokumentace Googlu k funkcím AI neplatí žádná zvláštní pravidla ani zvláštní strukturovaná data.
„Pro zobrazení v přehledech od AI ani v Režimu AI neexistují žádné další požadavky.“
Google Search Central, AI features and your website, 2025
Z mého pohledu to znamená, že se entita a asociace budují stejnou prací jako viditelnost v Googlu. Jen víc záleží na tom, co o vás říkají ostatní, než na tom, co říkáte sami.
Šest kategorií, ve kterých hlídat asociace
S klienty pracuji se šesti kategoriemi asociací, které vedou od entity značky. Každou jde ovlivnit webem, anchor texty a externími zmínkami a každou jde ověřit otázkami v AI, které položíte opakovaně.
- Produkty. Co prodáváte. „Co prodává X?“
- Kategorie. Širší oblast, ve které chcete být první volbou. „Kde koupit dárek pro muže?“ Zazníte?
- Brandové atributy. Jaká značka je. „Jaká je značka X?“
- Konkurenční značky. S kým vás AI srovnává. „Jaké jsou alternativy k X?“
- Osoby a charaktery. Zakladatel, tvář nebo maskot. „Kdo stojí za X?“
- Situace a související slova. Chvíle, kdy si na vás má zákazník vzpomenout. „Co koupit tátovi k Vánocům?“
Na Alze je to vidět i bez měření. Produkty jsou notebooky a mobily, kategorie elektronika, atributy rychlost a obří výběr, srovnává se s Datartem nebo CZC. V osobách a charakterech má Alzáka, v situacích „potřebuju to hned“. Obsazené má všech šest kategorií a všude opakuje stejný příběh.
Opak je dobře vidět na Manboxeu, e-shopu s originálními dárky, se kterým dlouhodobě pracuji.
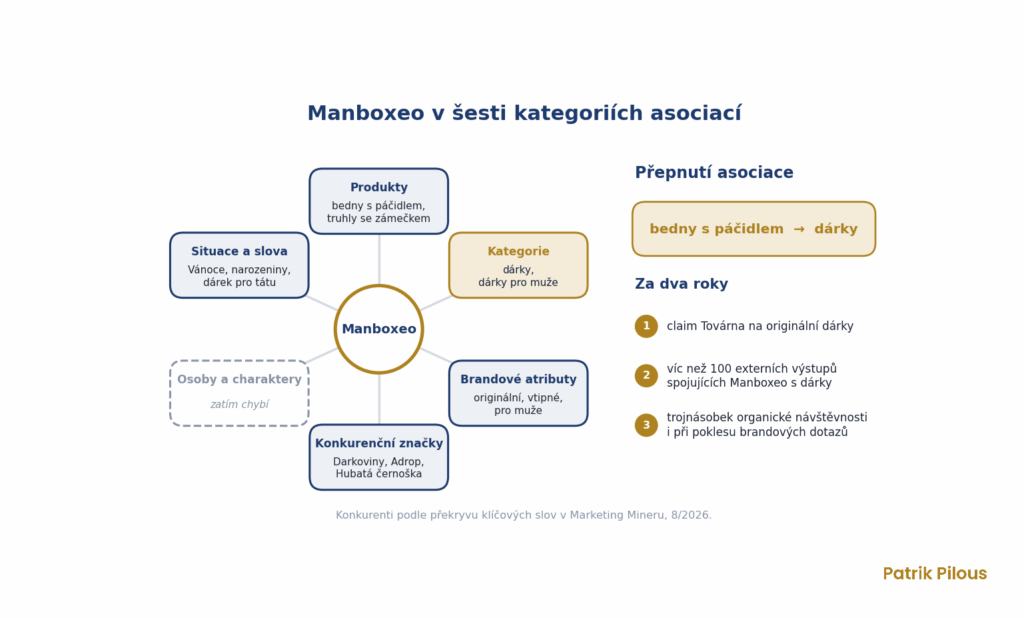
Pět kategorií je obsazených, osoby a charaktery zůstávají prázdné. Značka nemá tvář ani postavu, kterou by si lidé zapamatovali, a to je zároveň nejlevnější místo, kde se dá něco získat. Konkurenty v diagramu beru podle překryvu klíčových slov v Marketing Mineru, ne podle toho, koho by si značka přála.
Jak se dá asociace posunout
Asociace nejsou dané jednou provždy. U Manboxea jsme začínali se silnou vazbou na bedny s páčidlem. Zajímavý produkt, ale malý trh, který je potřeba pořád budovat.
Dotaz „bedna s páčidlem“ má podle Marketing Mineru v průměru 230 hledání měsíčně, samotné „dárky pro muže“ 11 000, tedy skoro padesátkrát víc, a v prosinci 2025 to bylo 38 000 (Česko, posledních 12 měsíců, odhad nástroje). Dárky jsou navíc kategorie, ve které lidé nakupují opakovaně.
Za dva roky vznikl slogan Továrna na originální dárky a víc než sto externích výstupů, které spojují Manboxeo s dárky. Hodně udělaly anchor texty. Kromě samotné značky i značka spojená s tím, co nabízí, třeba „Manboxeo, dárky pro muže“.
Organická návštěvnost se za ty dva roky ztrojnásobila, i když brandových dotazů ubylo. Když celkem roste a brand klesá, musel růst přijít z dotazů, ve kterých jméno značky vůbec není. Na webu se za tu dobu změnilo víc věcí, takže celý růst nepřipisuji asociacím. Směr ale sedí přesně s tím, o co šlo.
Co do externích textů psát, naznačuje studie o optimalizaci pro generativní vyhledávače z Princetonu a dalších pracovišť. Viditelnost textu v odpovědích AI nejvíc zvedlo doplnění zdrojů, citátů a statistik, relativně o 30 až 40 %, nacpání klíčových slov skoro nepomohlo. Je to jedna studie na vlastní sadě dotazů a na značky ji přenáším já. Text s čísly a fakty o značce ale podle ní má větší šanci, že se v odpovědi objeví.
Negativní asociace se musí vyvrátit
U Manboxea se objevovaly tři pochybnosti. „Je to kravina.“ „Je to fake.“ „Je to z Číny.“ Pochybnost, kterou internet opakuje a nikdo ji nevyvrací, AI klidně zopakuje taky.
Když o vás AI říká něco negativního a odpověď ukazuje zdroje (Perplexity a vyhledávání v ChatGPT je ukazují skoro vždy), najděte, odkud to bere, a odpovězte tam, kde se o vás mluví.
- Na webu přímou odpovědí na každou pochybnost. Kdo produkt vyrábí, z čeho a kde.
- U zákazníků recenzemi a videi z rozbalování, které ukážou skutečný produkt.
- Venku externími články, které říkají pravdu vlastními slovy.
Padesát kopií jedné tiskové zprávy nemá padesátkrát větší váhu, protože se téměř shodné texty v trénovacích datech často slučují. Výzkumníci z Googlu a Pensylvánské univerzity ukázali, jak velké opakování v datech bývá. V sadě C4 našli větu o 61 slovech, která se v ní opakovala přes 60 000krát, a modely po vyčištění opakování vypisovaly naučený text doslova desetkrát méně často.
Víc proto váží deset různých webů, které stejnou věc řeknou po svém, než jeden text rozeslaný na padesát adres.
Jak si vést měsíční kontrolu asociací
Jednou za měsíc položte ChatGPT, Gemini a Perplexity otázky ze všech šesti kategorií a odpovědi si zapište. Ke každé kategorii si připravte pět různě formulovaných otázek a každou zadejte víckrát v novém okně. SparkToro nechal 600 dobrovolníků zadat 12 dotazů do tří nástrojů, dohromady 2 961krát. Stejný seznam značek se vrátil méně než jednou ze sta, ve stejném pořadí méně než jednou z tisíce.
Rozhoduje proto podíl odpovědí, ve kterých se značka objeví, ne pořadí v jedné z nich. (Výzkum dělal SparkToro se startupem Gumshoe, který měření viditelnosti v AI prodává, takže s nadhledem.)
Do měsíčního sloupce tabulky zapište podíl odpovědí, které sedí s cílem (třeba 9 z 30), a co se v nich opakovalo. V tabulce je u každé kategorie jen první otázka.
| Kategorie | Otázka pro AI | S čím chceme být spojení | Měsíc 1 | Měsíc 2 | Měsíc 3 |
|---|---|---|---|---|---|
| Produkty | Co prodává X? | ||||
| Kategorie | Kde koupit dárek pro muže? | ||||
| Brandové atributy | Jaká je značka X? | ||||
| Konkurenční značky | Jaké jsou alternativy k X? | ||||
| Osoby a charaktery | Kdo stojí za X? | ||||
| Situace | Co koupit tátovi k Vánocům? |
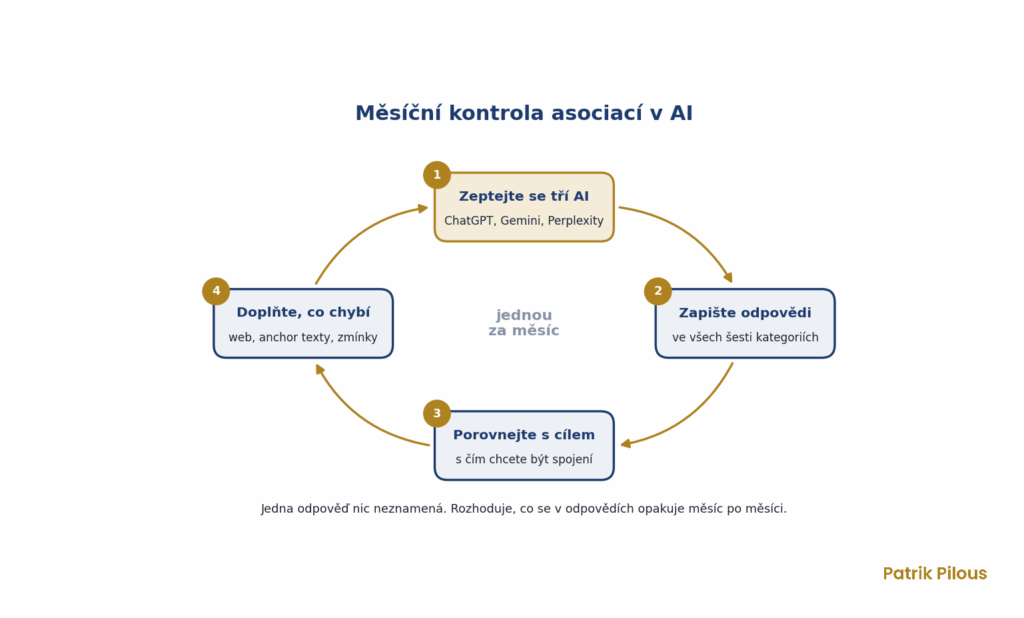
Výsledek porovnejte s tím, s čím chcete být spojení, a co chybí, doplňte na web i do zmínek venku. Ručně se to dá zvládnout u pár desítek dotazů, víc už je lepší měřit nástrojem, který prompty pokládá opakovaně a počítá podíl zmínek. Já na to používám Marketing Miner.
Kolik odpovědí potřebujete, aby čísla něco říkala
Z pár odpovědí posun od náhody nepoznáte. Když vás AI zmíní v 15 odpovědích z 30, je to 50 %, skutečná hodnota ale s 95% jistotou leží jen někde zhruba mezi 32 a 68 %. Rozpětí se zužuje pomalu, s odmocninou počtu odpovědí.
| Odpovědí v jedné kategorii | Rozpětí při podílu 50 % (v procentních bodech) | Jaký posun mezi dvěma měsíci odlišíte od náhody |
|---|---|---|
| 10 | ± 31 | přes 40 bodů, tedy skoro žádný |
| 30 | ± 18 | zhruba 25 bodů a víc |
| 100 | ± 10 | zhruba 15 bodů |
| 400 | ± 5 | zhruba 7 bodů, to už chce nástroj |
Šest kategorií, pět otázek v každé, tři modely a dvě opakování dávají 180 odpovědí měsíčně, tedy 30 na kategorii. Změnu menší než zhruba 25 bodů mezi dvěma měsíci proto neberte jako posun, ale jako šum. Tři modely jsou přitom v jednom čísle, srovnávat je mezi sebou z deseti odpovědí na každý nejde.
Jde o nejhorší případ kolem 50 %, u nízkých podílů je rozpětí užší. A počítá se s tím, že odpovědi jsou na sobě nezávislé, což u opakovaných dotazů platí jen přibližně, takže skutečná nejistota bývá spíš větší.
Kde začít u vás
Nejdřív entita. Napište tu jednu větu o značce a sjednoťte ji spolu se základními fakty na webu, v katalozích a na sociálních sítích. Na Wikidatech hlídejte aspoň fakta. Dokud entita nesedí všude stejně, nemají asociace z čeho růst.
Pak asociace. Měřte všech šest kategorií, ale pracujte jen na dvou až třech, kde je mezera mezi tím, co AI říká, a tím, co chcete, největší a kde na tom zároveň nejvíc záleží obchodně. Všech šest najednou se posunout nedá a rozpočet rozdělený na šest dílů nepohne ani jedním.
| Týden | Co udělat | Co máte na konci |
|---|---|---|
| 1 | napsat jednu větu o entitě a projít fakta napříč zdroji | větu a seznam míst k opravě |
| 2 | opravit web a vlastní profily, doplnit Organization a sameAs | stejná fakta všude, kde je máte v rukou |
| 3 | první měření všech šesti kategorií | výchozí tabulku |
| 4 | vybrat dvě až tři kategorie s největší mezerou | plán obsahu a externích zmínek |
U Manboxea trvalo dva roky, než se posun od beden s páčidlem k dárkům propsal do návštěvnosti. Výsledky proto vyhodnocujte po čtvrtletích. Čtvrtletí navíc dá 90 odpovědí na kategorii a rozpětí kolem 10 bodů, takže se z něj dá vyčíst víc než z jednoho měsíce.
Jak do toho zapadá zbytek práce ve vyhledávání, popisuji v článku Jak funguje SEO a GEO. Pokud chcete, abych se na entitu a asociace vaší značky podíval, ozvěte se přes stránku GEO, SEO pro AI.