

Duplicitní obsah je situace, kdy je stejný nebo velmi podobný text (nebo celkově html obsah) dostupný na více adresách, ať už v rámci jednoho webu, nebo napříč více weby. Chyba často vzniká i tak, že na charakterově odlišné stránky dáme totožný nadpis a meta titulek. Například hlavní kategorie, podkategorie, homepage i článek mají v nadpisu „Sportovní oblečení“. Tím máme na webu duplicitu a jednak mateme Google a znesnadňujeme přístup k té nejlepší stránce a za druhé taky přicházíme o návštěvnost duplicitních stránek, které se správným titulkem a nadpisem mohly být indexované a navštěvované.
Problém není v tom, že by za to Google plošně trestal, jak se často mylně tvrdí. Problém je, že vyhledávač neví, kterou verzi má považovat za originál a kterou ukázat ve výsledcích. Síla se tak tříští mezi několik adres místo toho, aby posilovala jednu. Výsledkem jsou horší pozice, promrhaný rozpočet na procházení a zmatek v indexu. U e-shopů je to jeden z nejčastějších technických problémů vůbec.
Odkud se slovo bere
Slovo duplicitní pochází z latinského duplex, tedy dvojitý, zdvojený. Duplikát je kopie, druhé vyhotovení téhož. V kontextu webu jde přesně o tohle. O obsah, který existuje ve více kopiích na různých místech. Nemusí jít o úmysl ani o krádež, nejčastěji duplicita vzniká úplně nechtěně, technickým nedopatřením. A právě proto je zákeřná, protože o ní často ani nevíš, dokud ti neshodí výsledky SEO.
Krátká historie duplicitního obsahu
Duplicita trápila vyhledávače od začátku, ale zásadní zlom přišel v roce 2011 s Google aktualizací Panda. Ta začala tvrdě postihovat weby s tenkým a kopírovaným obsahem, tedy stránky, které nepřinášely nic vlastního.
Panda naučila celý obor, že na originalitě a přidané hodnotě záleží. Tenhle důraz na jedinečný a užitečný obsah je dnes silnější než kdy dřív, hlavně ve světě, kde umí kdokoli generovat text ve velkém, jak popisuji v článku o tom, jak funguje SEO a GEO.
Jak duplicitní obsah funguje z pohledu SEO
Nejčastěji duplicita nevzniká kopírováním, ale z variant jedné a téže URL. Stejná stránka dostupná přes http i https, s www i bez, s lomítkem i bez něj, nebo s parametry filtrů za otazníkem. Pro člověka je to táž stránka, pro robota čtyři různé adresy se stejným obsahem.
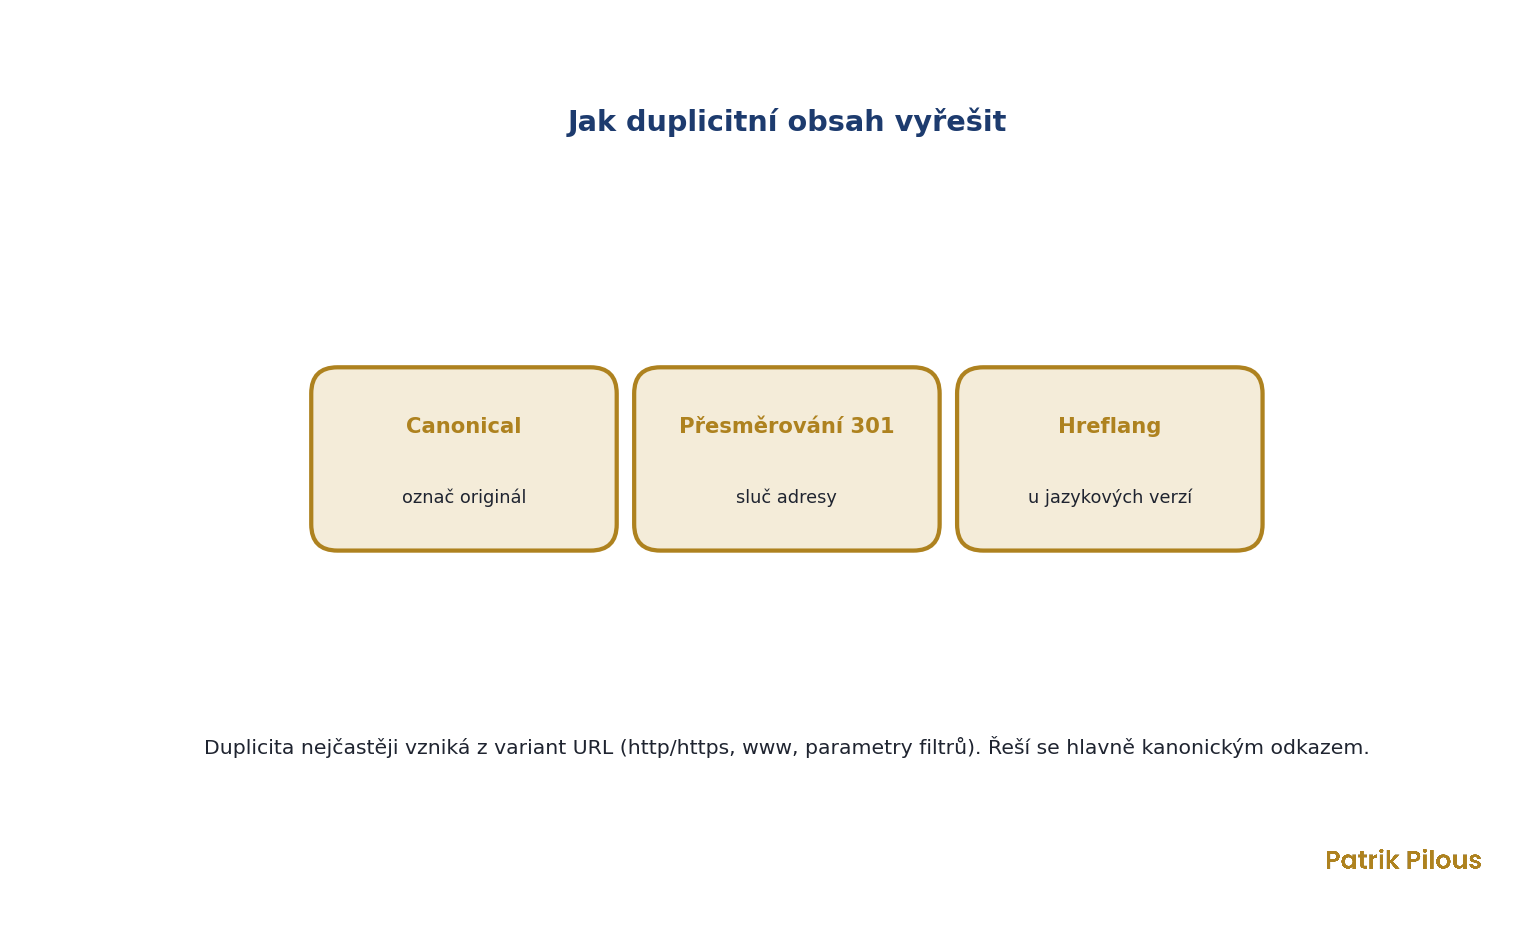
Hlavní nástroj na řešení je kanonický odkaz, kterým určíš, která verze je originál. U natrvalo zrušených duplicit použiješ přesměrování 301 a u jazykových mutací hreflang, aby si Google verze nespletl s duplicitou. Přehledná struktura webu pak riziko duplicit snižuje sama o sobě.
Další častou příčinou je absence kohokoliv, kdo trochu rozumí SEO na projektu. Mnoho různých stránek má duplicitní titulky a nadpisy. Správný postup je si celý web nacrawlovat, určit prioritní stránky a duplicity odstranit.
Proč na duplicitním obsahu záleží
Duplicita tě okrádá o výsledky, aniž bys o tom věděl. Místo jedné silné stránky, která by mohla mířit vysoko, máš několik slabých, které si navzájem berou pozice. Tomu se říká kanibalizace a je to častý důvod, proč se web nehne z místa navzdory kvalitnímu obsahu.
Odhalení a vyčištění duplicit proto patří k základní technické práci a je stálou součástí každého SEO auditu. Souvisí to i s klíčovými slovy, protože kanibalizace vzniká, když na stejné slovo cílí víc stránek najednou.
Kam to sahá dál
Duplicitní obsah je vlastně technická podoba pravdy, že když říkáš totéž na deseti místech, ztrácí to na síle. Hodnotu má originál, ne kopie. Je to i otázka důvěryhodnosti, tedy pilíře E-E-A-T, kterou opsaný obsah podkopává. Ve světě, kde umělá inteligence chrlí text po tisících, se jedinečnost a vlastní úhel pohledu stávají tím nejcennějším, co máš. A platí to nejen pro Google, ale i pro modely, které si vybírají, koho odcitovat. Ty taky nemají důvod sahat po desáté kopii téhož.
Nejčastější chyby
- Přesvědčení, že za duplicitní obsah Google plošně trestá. Netrestá, jen neví, kterou verzi ukázat.
- Chybějící kanonický odkaz na e-shopu s tisíci variant URL z filtrů a řazení.
- Řešení duplicit přes blokaci v robots.txt místo přes canonical nebo přesměrování.
- Stejné produktové popisky převzaté od výrobce, které má na webu i dalších padesát e-shopů.
Otázky kolem duplicitního obsahu
Co je duplicitní obsah?
Stejný nebo velmi podobný obsah dostupný na více adresách. Vyhledávač pak neví, kterou verzi považovat za originál a kterou ukázat ve výsledcích.
Trestá Google za duplicitní obsah?
Plošně ne. Problém je spíš v tříštění síly mezi víc adres a ve zmatku, kterou verzi zařadit. Výjimkou je záměrně kopírovaný a bezcenný obsah.
Jak vyřešit duplicitní obsah?
Nejčastěji kanonickým odkazem, který označí originál. U trvale zrušených adres přesměrováním 301, u jazykových verzí přes hreflang.


