

Duplicitný obsah je situácia, keď je rovnaký alebo veľmi podobný text (alebo celkovo HTML obsah) dostupný na viacerých adresách, či už v rámci jedného webu, alebo naprieč viacerými webmi. Chyba často vzniká aj tak, že na charakterovo odlišné stránky dáme totožný nadpis a meta titulok. Napríklad hlavná kategória, podkategória, homepage aj článok majú v nadpise „Športové oblečenie“. Tým máme na webe duplicitu, jednak mätieme Google a sťažujeme prístup k tej najlepšej stránke a jednak prichádzame o návštevnosť duplicitných stránok, ktoré by so správnym titulkom a nadpisom mohli byť indexované a navštevované.
Problém nie je v tom, že by za to Google plošne trestal, ako sa často mylne tvrdí. Problém je, že vyhľadávač nevie, ktorú verziu má považovať za originál a ktorú ukázať vo výsledkoch. Sila sa tak triešti medzi niekoľko adries namiesto toho, aby posilňovala jednu. Výsledkom sú horšie pozície, premrhaný rozpočet na prehľadávanie a zmätok v indexe. Pri e-shopoch je to jeden z najčastejších technických problémov vôbec.
Odkiaľ sa slovo berie
Slovo duplicitný pochádza z latinského duplex, teda dvojitý, zdvojený. Duplikát je kópia, druhé vyhotovenie toho istého. V kontexte webu ide presne o toto. O obsah, ktorý existuje vo viacerých kópiách na rôznych miestach. Nemusí ísť o úmysel ani o krádež, najčastejšie duplicita vzniká úplne nechcene, technickým nedopatrením. A práve preto je zákerná, pretože o nej často ani neviete, kým vám nezhodí výsledky SEO.
Krátka história duplicitného obsahu
Duplicita trápila vyhľadávače od začiatku, ale zásadný zlom prišiel v roku 2011 s aktualizáciou Google Panda. Tá začala tvrdo postihovať weby s tenkým a kopírovaným obsahom, teda stránky, ktoré neprinášali nič vlastné.
Panda naučila celý odbor, že na originalite a pridanej hodnote záleží. Tento dôraz na jedinečný a užitočný obsah je dnes silnejší než kedykoľvek predtým, hlavne vo svete, kde dokáže ktokoľvek generovať text vo veľkom, ako opisujem v článku o tom, ako funguje SEO a GEO.
Ako duplicitný obsah funguje z pohľadu SEO
Najčastejšie duplicita nevzniká kopírovaním, ale z variantov jednej a tej istej URL. Rovnaká stránka dostupná cez http aj https, s www aj bez, s lomkou aj bez nej, alebo s parametrami filtrov za otáznikom. Pre človeka je to tá istá stránka, pre robota štyri rôzne adresy s rovnakým obsahom.
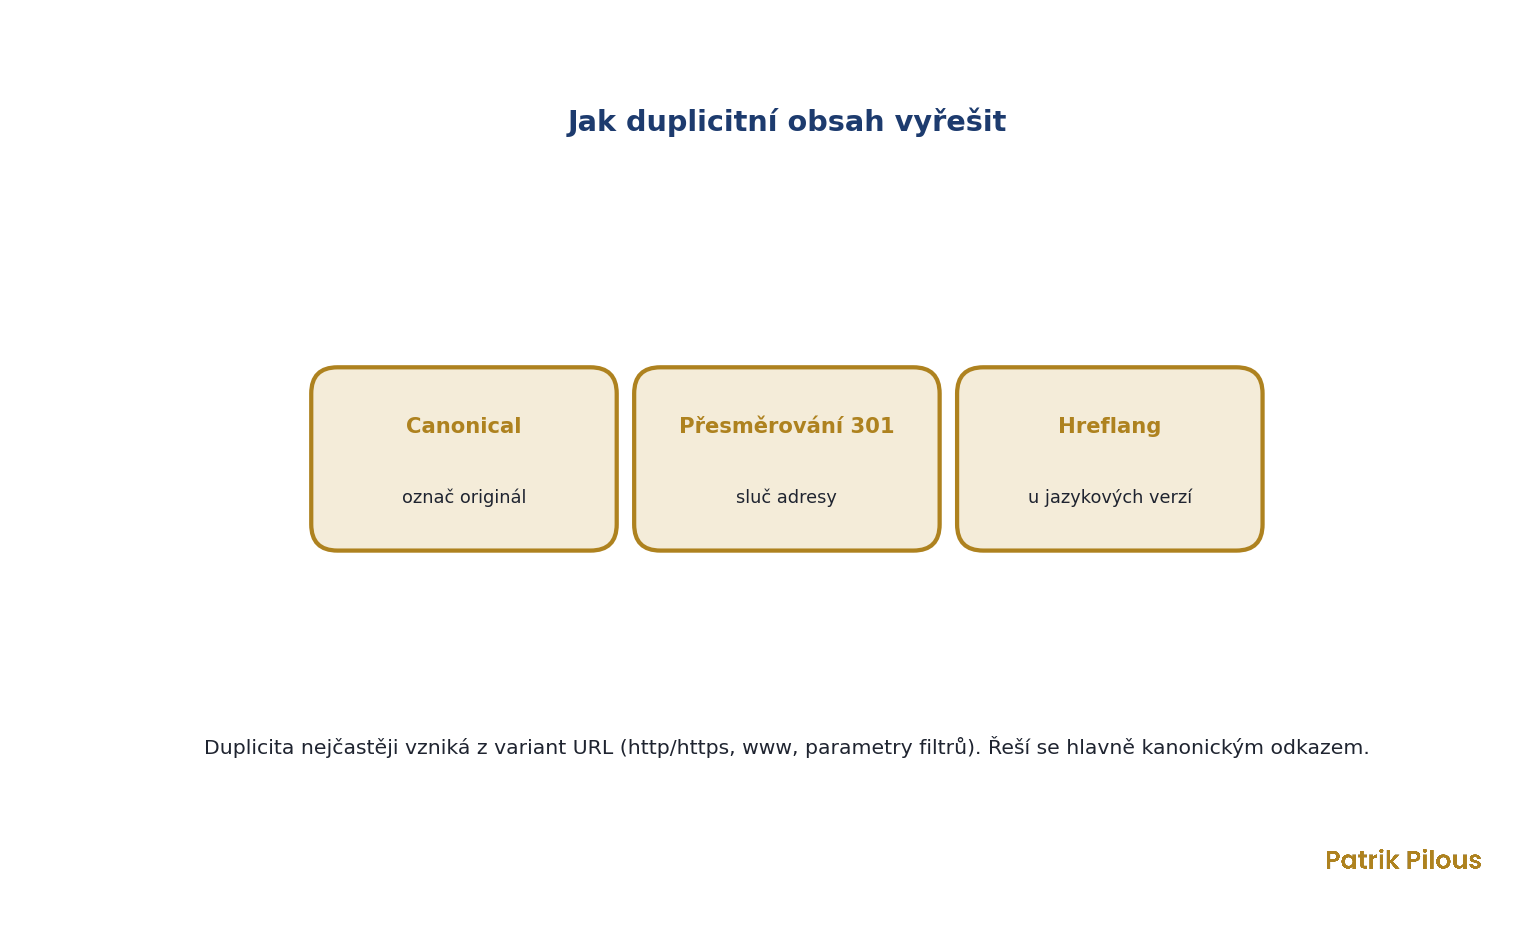
Hlavný nástroj na riešenie je kanonický odkaz, ktorým určíte, ktorá verzia je originál. Pri natrvalo zrušených duplicitách použijete presmerovanie 301 a pri jazykových mutáciách hreflang, aby si Google verzie nepomýlil s duplicitou. Prehľadná štruktúra webu potom riziko duplicít znižuje sama osebe.
Ďalšou častou príčinou je absencia kohokoľvek, kto trochu rozumie SEO, na projekte. Mnoho rôznych stránok má duplicitné titulky a nadpisy. Správny postup je celý web nacrawlovať, určiť prioritné stránky a duplicity odstrániť.
Prečo na duplicitnom obsahu záleží
Duplicita vás oberá o výsledky bez toho, aby ste o tom vedeli. Namiesto jednej silnej stránky, ktorá by mohla mieriť vysoko, máte niekoľko slabých, ktoré si navzájom berú pozície. Tomu sa hovorí kanibalizácia a je to častý dôvod, prečo sa web nepohne z miesta napriek kvalitnému obsahu.
Odhalenie a vyčistenie duplicít preto patrí k základnej technickej práci a je stálou súčasťou každého SEO auditu. Súvisí to aj s kľúčovými slovami, pretože kanibalizácia vzniká, keď na rovnaké slovo cieli viac stránok naraz.
Kam to siaha ďalej
Duplicitný obsah je vlastne technická podoba pravdy, že keď hovoríte to isté na desiatich miestach, stráca to na sile. Hodnotu má originál, nie kópia. Je to aj otázka dôveryhodnosti, teda piliera E-E-A-T, ktorú odpísaný obsah podkopáva. Vo svete, kde umelá inteligencia chrlí text po tisícoch, sa jedinečnosť a vlastný uhol pohľadu stávajú tým najcennejším, čo máte. A platí to nielen pre Google, ale aj pre modely, ktoré si vyberajú, koho citovať. Ani tie nemajú dôvod siahať po desiatej kópii toho istého.
Najčastejšie chyby
- Presvedčenie, že za duplicitný obsah Google plošne trestá. Netrestá, len nevie, ktorú verziu ukázať.
- Chýbajúci kanonický odkaz na e-shope s tisíckami variantov URL z filtrov a radenia.
- Riešenie duplicít cez blokovanie v robots.txt namiesto cez canonical alebo presmerovanie.
- Rovnaké produktové popisy prevzaté od výrobcu, ktoré má na webe aj ďalších päťdesiat e-shopov.
Otázky okolo duplicitného obsahu
Čo je duplicitný obsah?
Rovnaký alebo veľmi podobný obsah dostupný na viacerých adresách. Vyhľadávač potom nevie, ktorú verziu považovať za originál a ktorú ukázať vo výsledkoch.
Trestá Google za duplicitný obsah?
Plošne nie. Problém je skôr v triešte sily medzi viac adries a v zmätku, ktorú verziu zaradiť. Výnimkou je zámerne kopírovaný a bezcenný obsah.
Ako vyriešiť duplicitný obsah?
Najčastejšie kanonickým odkazom, ktorý označí originál. Pri trvalo zrušených adresách presmerovaním 301, pri jazykových verziách cez hreflang.

